
جلوگیری از کرال URL های فیلتر و پارامتردار در ووکامرس
سلام! من حمید امیدی هستم سلطان سئو تکنیکال :)
همین الان در حال آزادسازی بودجه خزش یکی از پروژه هایم در زمینه فروش تجهیزات دندانپزشکی بودم.
دوست داشتم تجربه ام را با شما درباره جلوگیری از خزش یو آر ال های بدرد نخور در ووکامرس در میان بگذارم.
ما روی سایت دنتی بازار در گزارش Page Indexing سرچ کنسول به حدود ۵۰۰۰ URL پارامتردار رسیدیم. نمونه شان:
/shop/?filter_size=20,30,45
/product-category/restorative/composite/universal/?filter_shade=a1
/shade/a2/?orderby=price&filter_shade=a1,a3
/?add-to-cart=45058&quantity=1
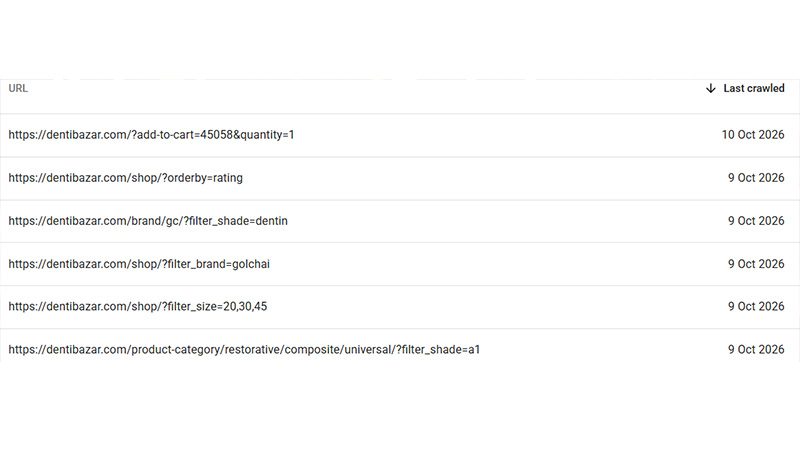
filter urls
در این سایت به یک بحران رسیدیم! صفحاتی که میخواستیم رتبه بگیرند، دیده نمی شدند و انگار قدرت سایت گرفته شده بود!
هیچ کدام صفحه ای نبودند که بخواهیم در گوگل دیده شود، ولی گوگل مرتب سراغشان می آمد.
در این مقاله می گویم این URL ها چه ضرری دارند، چطور بفهمیم کرال شده اند، و مهم تر از همه با چه ترتیبی باید مدیریتشان کرد.
این ترتیب جایی است که بیشتر آموزش ها اشتباه می کنند.
این URL ها چطور بودجه خزش را هدر می دهند؟
بودجه خزش (Crawl Budget) طبق توضیح گوگل از دو بخش تشکیل می شود:
ظرفیت خزش (چقدر می تواند به سرور فشار بیاورد بدون اینکه سایت کند شود) و تقاضای خزش (چقدر دلش می خواهد صفحات سایت را ببیند).
مشکل فیلترها ریاضی است. فرض کنید یک دسته ۵ فیلتر دارد و هر فیلتر چند مقدار. ترکیب این ها با مرتب سازی و صفحه بندی، تعداد URL های ممکن را به شکل ترکیبی بالا می برد:
دقت کنید :
/category/?filter_size=20
/category/?filter_size=20,30
/category/?filter_size=30,20 ← همان محتوا، ترتیب متفاوت
/category/?filter_size=20&orderby=price
/category/?filter_size=20&orderby=price&filter_shade=a1
…
گوگل در مستنداتش Faceted Navigation را صریحا یکی از منابع اصلی URL های کم ارزش و هدررفت کرال می داند. نتیجه چیست:
هدر رفتن کرال: گوگل وقتش را صرف صفحاتی می کند که هیچ ارزشی ندارند و دیر به محصول یا مقاله جدیدتان می رسد.
فشار روی سرور: هر URL فیلتردار معمولا کوئری دیتابیس سنگین تری دارد.
محتوای تکراری و رقابت داخلی: ده ها URL با محتوای تقریبا یکسان، سیگنال ها را پخش می کنند و گوگل باید حدس بزند کدام را نشان بدهد.
آلوده شدن گزارش ها: در سرچ کنسول پیدا کردن مشکل واقعی بین هزاران URL بی ارزش سخت می شود.
یک نکته صادقانه: گوگل می گوید بودجه خزش برای سایت های خیلی بزرگ یا سایت هایی که محتوایشان مرتب تغییر می کند بحرانی است.
اگر سایت شما چند صد محصول دارد، شاید «بودجه» مشکل اصلی نباشد، ولی تکراری شدن، فشار روی سرور و شلوغ شدن گزارش ها همچنان واقعی است.
پس مقیاس مشکل را درست بسنجید و آن را بزرگ تر از آنچه هست جلوه ندهید.
از کجا بفهمیم این URL ها کرال شده اند؟
دو منبع داریم، از ساده تا دقیق:
۱. گزارش Page Indexing در سرچ کنسول
به Indexing > Pages بروید و وضعیت ها را ببینید:
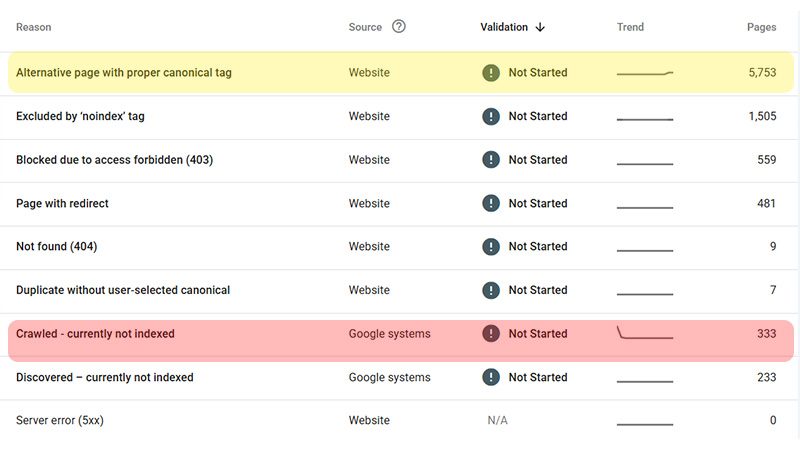
pages سرچ کنسول
Crawled – currently not indexed: گوگل دیده ولی ایندکس نکرده.
Discovered – currently not indexed: لینکش را پیدا کرده ولی هنوز نیامده.
Duplicate without user-selected canonical / Alternate page with proper canonical tag: گوگل دیده و به عنوان تکراری کنار گذاشته.
Indexed: ایندکس شده (این مهم ترین گروه برای تصمیم گیری است).
برای فیلتر کردن، از Add filter > Page URL contains استفاده کنید و عباراتی مثل filter_ یا orderby= را بنویسید.
رابط کاربری سرچ کنسول در لیست URL ها محدودیت نمایش دارد؛ برای حجم بالا از Search Console API یا Bulk Data Export به BigQuery استفاده کنید.
همچنین اگر بخواهید تاریخ کرال شدن یو آر ال های پارامتری را ببینید، کافیست از آن یو آر ال اینسپکت بگیرید و تاریخ را ببینید.به تصویر زیر دقت کنید :
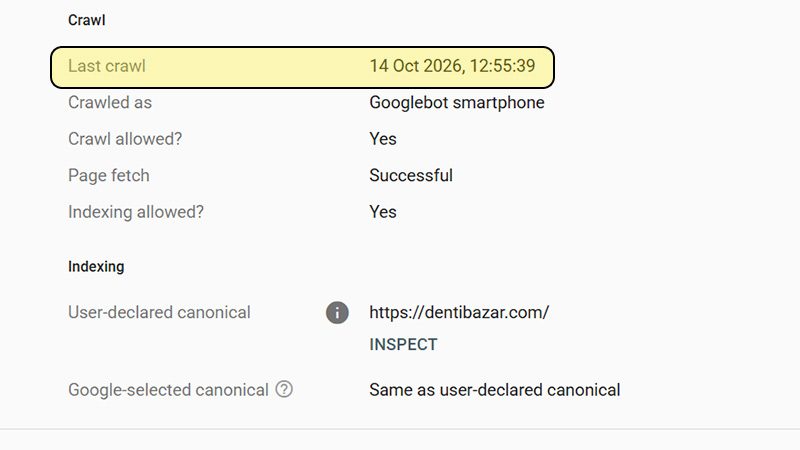
خزش گوگل
۲. گزارش Crawl Stats
در Settings > Crawl stats می توانید ببینید گوگل روزانه چند درخواست می زند و پاسخ ها چه کدی دارند. این گزارش نمای کلی است و فهرست کامل URL ها را نمی دهد، ولی روند را نشان می دهد: بعد از اصلاحات باید افت کرال را اینجا ببینید.
با این URL ها چه رفتاری باید داشت؟
اشتباه رایج این است که با دیدن URL های اضافی، فورا Disallow بنویسیم. قبل از هر اقدامی دو چیز را بررسی کنید:
قدم اول: canonical و تگ robots هر URL
چند URL نمونه را باز کنید و View Source بگیرید:
<link rel="canonical">به کجا اشاره می کند؟ به خودش، یا به صفحه اصلی دسته؟<meta name="robots">چه می گوید؟ (index، noindex یا چیز دیگر)
گاهی افزونه سئو یا قالب خودش مشکل را تا حدی حل کرده است.
اگر canonical درست به صفحه اصلی دسته اشاره می کند و گوگل هم آن را پذیرفته (در URL Inspection ببینید)، شاید نیاز به اقدام سنگین نباشد.
یادآوری مهم: canonical یک پیشنهاد است، نه دستور. گوگل ممکن است نادیده اش بگیرد.
قدم دوم: وضعیت ایندکس
حالا تصمیم بر اساس اینکه URL ها ایندکس شده اند یا نه:
| وضعیت | اقدام |
|---|---|
| ایندکس نشده (فقط کرال می شوند) | مستقیم با robots.txt ببندید |
| ایندکس شده، تعداد کم و بدون ایمپرشن | robots.txt بگذارید؛ می توانید از Removals برای حذف موقت هم کمک بگیرید |
| ایندکس شده، تعداد زیاد | اول canonical درست یا noindex، بعد از خروج از ایندکس، robots.txt |
| صفحه ای که تقاضای جستجو دارد | بسته نکنید؛ صفحه ثابت و بهینه بسازید (پایین تر توضیح می دهم) |
اگر ایندکس شده بودند چه کنیم؟
قانون طلایی: گوگل برای دیدن noindex یا canonical باید صفحه را کرال کند.
اگر قبل از خروج از ایندکس، آن را در robots.txt ببندید، گوگل دیگر نمی تواند صفحه را بخواند، پس نه noindex را می بیند و نه canonical را. نتیجه این می شود که URL با وضعیت «Indexed, though blocked by robots.txt» در نتایج می ماند، معمولا بدون توضیح متا و با محتوایی ناقص.
گزینه ها:
- canonical به صفحه اصلی دسته: معمولا گزینه اول برای فیلترهاست چون سیگنال ها را هم منتقل می کند، ولی قطعی نیست.
- noindex: قطعی تر. هم با meta robots و هم با هدر
X-Robots-Tagقابل پیاده سازی است. توجه کنید کهnoindex, followدر بلندمدت تضمین نمی کند لینک های داخل صفحه همچنان دنبال شوند.
سپس صبر کنید و گزارش Page Indexing را ببینید. بر اساس تجربه عمومی، این فرآیند از چند هفته تا چند ماه طول می کشد (عدد دقیقی نمی شود داد و به ارزش سایت و فرکانس کرال بستگی دارد).
اگر ایندکس نشده بودند چه کنیم؟
ساده تر است: مستقیم بروید سراغ robots.txt. این URL ها فقط بودجه کرال می خورند و دلیلی برای صبر نیست.
چطور با robots.txt ببندیم؟
اصول سینتکس
*یعنی هر دنباله از کاراکترها، و$یعنی انتهای URL.- الگوی
/*?*filter_یعنی هر URL که در query string اشfilter_داشته باشد. - اگر قاعده Allow و Disallow با هم تداخل کنند، گوگل قاعده خاص تر (با مسیر طولانی تر) را اعمال می کند.
- robots.txt کرال را کنترل می کند، نه ایندکس را.
بنابراین یک فایل تغییر یافته robots را به صورت زیر میبینید :
Disallow: /*?*filter_
Disallow: /*?*query_type_
Disallow: /*?*orderby=
Disallow: /*?*min_price=
Disallow: /*?*max_price=
Disallow: /*?*rating_filter=
Disallow: /*?*per_page=
Disallow: /*?s=
Disallow: /*&s=
Disallow: /search/
نکات اجرایی
- اسلاگ های
/cart/،/checkout/و/my-account/را با سایت خودتان مطابقت بدهید. اگر فارسی یا متفاوت است، همان را بنویسید. - ببینید robots.txt فایل فیزیکی است یا مجازی (که وردپرس یا افزونه سئو می سازد). همان جا را ویرایش کنید، وگرنه تغییر اعمال نمی شود.
- CSS و JS را بلاک نکنید (
/wp-content/و/wp-includes/)، چون گوگل برای رندر صفحه به آن ها نیاز دارد. - کامنت فارسی داخل robots.txt لازم نیست؛ اگر خواستید کامنت بگذارید، انگلیسی و کوتاه بنویسید.
بعد از بستن چه کنیم؟
بستن robots.txt پایان کار نیست، شروع پایش است.
۱. تست: در Settings > robots.txt سرچ کنسول، فایل را بررسی کنید که بدون خطا خوانده شده باشد.
چند URL نمونه را با URL Inspection تست کنید: فیلترها و add-to-cart باید «blocked» باشند و صفحات دسته، محصول و /shade/a2/ باید باز باشند.
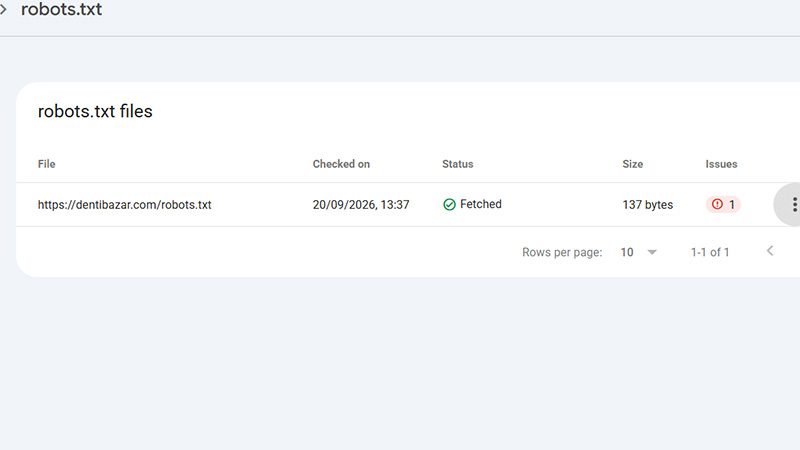
robots.txt crawl request
۲. پایش Crawl Stats: بعد از چند هفته انتظار داریم درخواست به URL های پارامتردار کم شود. اگر لاگ سرور دارید، سهم URL های دارای ? را از کل درخواست های Googlebot مقایسه کنید.
۳. پایش Page Indexing: وضعیت «Blocked by robots.txt» طبیعی است. نگران «Indexed, though blocked by robots.txt» هم نباشید اگر تعدادش در حال کاهش است. اگر بعد از مدت طولانی ثابت ماند، موقتا باز کنید، noindex بگذارید و دوباره ببندید.
۴. سایت مپ: مطمئن شوید هیچ URL فیلتردار یا پارامتردار در سایت مپ نیست.
۵. لینک دهی داخلی: robots.txt فقط مصرف را کم می کند، ولی منبع مشکل لینک های داخلی است. اگر فیلترها به صورت <a href> قابل خزش در HTML هستند، گوگل مدام آن ها را کشف می کند. در صورت امکان، فیلترها را با AJAX یا بدون href قابل خزش بسازید.
۶. نکته مهم: گوگل ابزار URL Parameters را سال ۲۰۲۲ بازنشسته کرد. پس مدیریت پارامترها فقط با canonical، noindex، robots.txt و ساختار لینک دهی ممکن است.
نکات تکمیلی: همه فیلترها را نبندید
زاویه ای که فکر می کنم کمتر به آن پرداخته می شود: تفاوت بین فیلتر برای کاربر و صفحه برای جستجو.
در دنتی بازار، «کامپوزیت شید A1» ممکن است عبارتی باشد که کاربران واقعا جستجو می کنند.
اگر این را فقط با ?filter_shade=a1 ارائه بدهیم، یک URL موقتی و بی ارزش است.
ولی اگر مثل /shade/a1/ یک صفحه ثابت، با محتوای یکتا، عنوان و توضیح اختصاصی باشد، می تواند رتبه بگیرد. به همین دلیل در سایت ما صفحات تاکسونومی مثل /shade/a2/ باز می مانند و فقط نسخه های پارامتردار بسته می شوند.
قاعده تصمیم گیری:
- فیلتری که تقاضای جستجو دارد → صفحه ثابت با محتوای اختصاصی بسازید.
- فیلتری که فقط راحتی کاربر است → noindex یا canonical، بعد robots.txt.
- ترکیب چند فیلتر با هم و مرتب سازی → همیشه بسته.
اشتباهات رایج
- بستن robots.txt قبل از خروج URL ها از ایندکس.
- گذاشتن noindex روی URL ای که در robots.txt بسته است (گوگل هرگز نمی بیندش).
- بلاک کردن CSS و JS.
- فرض اینکه robots.txt «حذف از گوگل» است.
- قرار دادن URL های فیلتردار در سایت مپ.
- تغییر فایل و نتست نکردن آن.
جمع بندی
۱. اول تشخیص بدهید: URL ها کرال می شوند یا ایندکس هم شده اند؟
۲. canonical و تگ robots چند نمونه را بررسی کنید.
۳. اگر ایندکس نشده اند، مستقیم robots.txt. اگر ایندکس شده اند، اول canonical یا noindex، بعد robots.txt.
۴. بعد از بستن، پایش کنید و سایت مپ و لینک دهی داخلی را هم اصلاح کنید.
۵. فیلترهایی که تقاضای جستجو دارند را به صفحه ثابت تبدیل کنید.
چند سوال متداول (FAQ)
آیا robots.txt باعث حذف صفحه از گوگل می شود؟ خیر. فقط کرال را متوقف می کند و ممکن است URL بدون محتوا همچنان ایندکس بماند.
بهتر است canonical بگذارم یا noindex؟ برای فیلترها معمولا canonical به صفحه اصلی دسته، و اگر قطعیت می خواهید noindex.
هر دو را با هم روی یک URL می توان گذاشت ولی سیگنال متناقض نباشد.
آیا گوگل دستور nofollow داخلی را رعایت می کند؟ گوگل nofollow را «hint» می داند. برای کنترل کرال داخلی، تکیه بر آن کافی نیست.
بیشتر در اینباره بدانید : بهینه سازی نرخ خزش


دیدگاه خود را ثبت کنید
تمایل دارید در گفتگوها شرکت کنید؟در گفتگو ها شرکت کنید.